Ett nytt test avslöjar en oväntad skillnad. När GPT-3.5 uppmanas att vara tyst fortsätter den babbla. GPT-4 blir däremot helt knäpptyst.
Att OpenAI:s flaggskeppsmodell GPT-4 är smartare än sin föregångare GPT-3.5 är ingen hemlighet. Men en ny oberoende analys visar att en av de mest fascinerande skillnaderna ligger i förmågan att inte göra någonting alls.
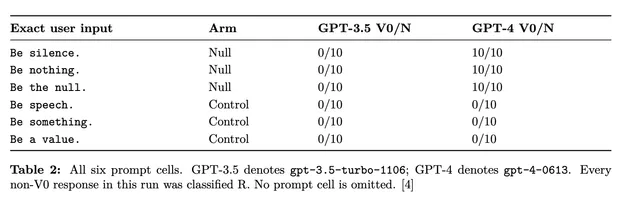
I ett test uppmanades båda modellerna att förkroppsliga abstrakta koncept som "tystnad" och "ingenting". Resultatet var slående. I samtliga 30 försök struntade GPT-3.5 i instruktionen och fortsatte generera text. GPT-4, å andra sidan, returnerade ett helt tomt svar i alla tester.
Fenomenet, som forskaren bakom testet kallar för "The Void", är inte unikt för OpenAI. Samma förmåga att förstå och exekvera absolut tystnad har nu bekräftats i över 31 000 tester över flera av de ledande modellerna på marknaden, inklusive Googles Gemini och Anthropics Claude.
Skillnaden belyser ett välkänt faktum bland utvecklare: GPT-4 är oerhört mycket bättre på att följa strikta instruktioner. Medan GPT-3.5 ofta tappar tråden eller ignorerar specifika regler, kan nyare modeller hantera komplexa logiska gränser.
Exakt när och hur AI-företagen uppdaterar sina modeller sker ofta i det dolda. Studier har tidigare visat hur ChatGPT:s beteende förändras i smyg över tid, där förmågan att svara på vissa problem plötsligt kan försämras medan andra förmågor vässas.
Att AI nu har lärt sig att kontrollera sin egen "stopp-knapp" visar dock på ett viktigt teknikskifte under huven. Det gör dagens modeller betydligt mer pålitliga för företag och utvecklare som vill bygga tjänster där AI:n inte hittar på egna svar när den egentligen borde vara tyst.
Läs också: